本文主要介绍 Elastic Stack 的使用和原理。
安装
推荐使用 Docker 安装。可以参考官方文档。
首先创建一个网络:
docker network create elastic
然后拉取 Elasticsearch 和 Kibana 镜像:
docker pull docker.elastic.co/elasticsearch/elasticsearch:8.17.2
docker pull docker.elastic.co/kibana/kibana:8.17.2
启动 Elasticsearch:
docker run -d --name es -e "ES_JAVA_OPTS=-Xms512m -Xmx512m" -e "discovery.type=single-node" -e "xpack.security.enabled=false" -v es-data:/usr/share/elasticsearch/data -v es-plugins:/usr/share/elasticsearch/plugins --privileged --net elastic -p 9200:9200 -p 9300:9300 -it -m 1GB docker.elastic.co/elasticsearch/elasticsearch:8.17.2
相比官方文档,我们添加了一些参数,尤其是
-e "xpack.security.enabled=false"来禁用 ES 8.0 之后的默认安全特性。我们这里只是为了测试,如果要进行生产环境部署,还是建议开启安全特性。
启动完成后,访问 http://localhost:9200 应该可以看到 Elasticsearch 的信息。
{
  "name" : "95dbc32053ac",
  "cluster_name" : "docker-cluster",
  "cluster_uuid" : "0DpZs4yMSEqrtqv4iEiM4g",
  "version" : {
    "number" : "8.17.2",
    "build_flavor" : "default",
    "build_type" : "docker",
    "build_hash" : "747663ddda3421467150de0e4301e8d4bc636b0c",
    "build_date" : "2025-02-05T22:10:57.067596412Z",
    "build_snapshot" : false,
    "lucene_version" : "9.12.0",
    "minimum_wire_compatibility_version" : "7.17.0",
    "minimum_index_compatibility_version" : "7.0.0"
  },
  "tagline" : "You Know, for Search"
}
接下来开启 Kibana:
docker run -d --name kib --net elastic -p 5601:5601 -e "ELASTICSEARCH_HOSTS=http://es:9200" docker.elastic.co/kibana/kibana:8.17.2
Kibana 启动需要一小会儿,启动完成后访问 http://localhost:5601 应该可以看到 Kibana 的界面。
点击左上角的图标,找到 Dev Tools,可以在这里编写 DSL 查询 Elasticsearch。
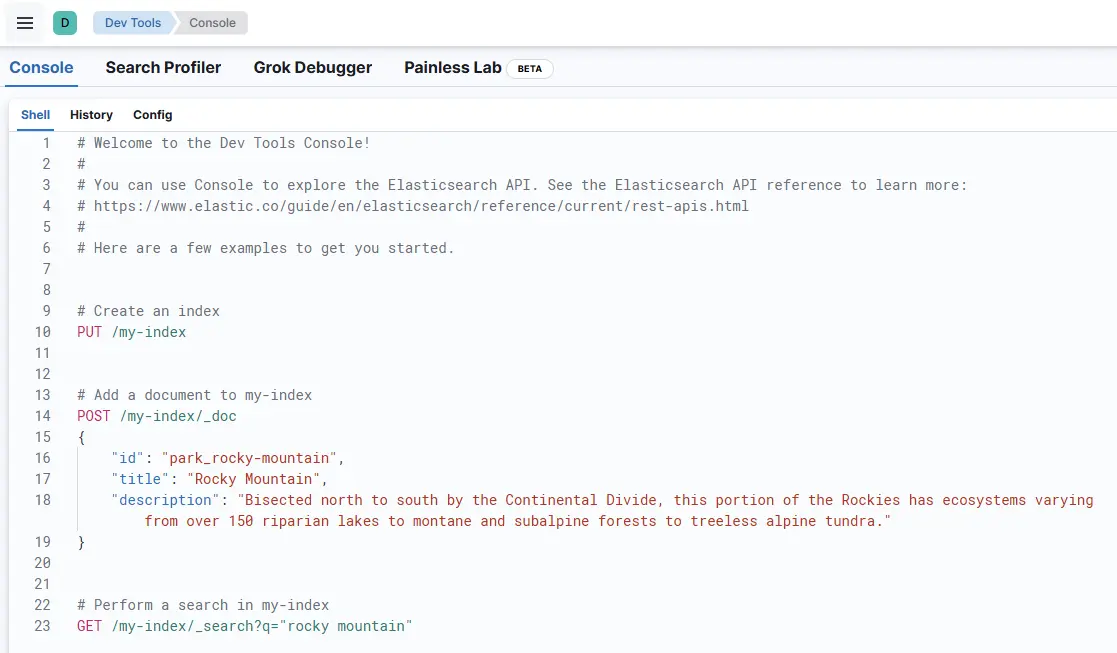
标准版的 Elasticsearch 只支持英文分词,如果需要支持中文分词,可以安装 IK 分词器:
docker exec -it es /bin/bash
bin/elasticsearch-plugin install https://get.infini.cloud/elasticsearch/analysis-ik/8.4.1
exit
docker restart es
我发现这里网络好像不太行,所以采取了手动下载的方式。
首先访问官网下载地址,下载下来。我这里是下载的
elasticsearch-analysis-ik-8.17.2.zip。解压并重命名为
ik将解压后的文件夹上传到容器中:
docker cp ik es:/usr/share/elasticsearch/plugins/ik重启容器:
docker restart es
现在,我们在 Dev Tools 中做一下简单的测试:
GET /_analyze
{
  "analyzer": "ik_max_word",
  "text": "我是程序员!"
}
可以看到分词结果:
{
  "tokens": [
    {
      "token": "我",
      "start_offset": 0,
      "end_offset": 1,
      "type": "CN_CHAR",
      "position": 0
    },
    {
      "token": "是",
      "start_offset": 1,
      "end_offset": 2,
      "type": "CN_CHAR",
      "position": 1
    },
    {
      "token": "程序员",
      "start_offset": 2,
      "end_offset": 5,
      "type": "CN_WORD",
      "position": 2
    },
    {
      "token": "程序",
      "start_offset": 2,
      "end_offset": 4,
      "type": "CN_WORD",
      "position": 3
    },
    {
      "token": "员",
      "start_offset": 4,
      "end_offset": 5,
      "type": "CN_CHAR",
      "position": 4
    }
  ]
}
这里,我们使用了 ik_max_word 分词器,它表示最大词长分词器,会将文本尽可能多的分成词。还有一个 ik_smart 分词器,它表示智能分词器,会将文本尽可能少的分成词。
我们也可以添加扩展词包:
- 在
ik文件夹下创建一个ext.dic文件,向其中添加扩展词,每行一个。 -
配置
ik文件夹下的IKAnalyzer.cfg.xml文件,添加扩展词包路径:<?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE properties SYSTEM "http://java.sun.com/dtd/properties.dtd"> <properties> <comment>IK Analyzer 扩展配置</comment> <entry key="ext_dict">ext.dic</entry> </properties> - 重启容器。
索引
反向索引
MySQL 等关系型数据库是基于行存储的,其索引为正向索引。而 Elasticsearch 是基于反向索引的。
反向索引包含了两个概念:
- 文档(Document):用来搜索的数据,例如一个网页、一篇文章等。
- 词(Term):文档中的一个词,例如一个单词、一个短语等。
例如,我们有如下文档:
id | title | price |
|---|---|---|
| 1 | 大米手机 | 1999 |
| 2 | 菠萝手机 | 9999 |
| 3 | 大米手环 | 299 |
| 4 | 大米手机充电器 | 99 |
我们希望根据 title 字段搜索,如果使用正向索引,那么我们需要遍历所有文档,找到 title 字段,然后进行匹配。这样的效率是非常低的。
而反向索引则首先将所有文档中的 title 字段进行分词,然后将每个词与文档的关系进行映射。例如,大米 这个词出现在了文档 1、3、4 中,那么反向索引就会记录 大米 与 1、3、4 的关系。
| 大米 | [1, 3, 4] |
| 手机 | [1, 2, 4] |
| 菠萝 | [2] |
| 手环 | [3] |
| 充电器 | [4] |
假如我们搜索 大米手机。首先将 大米 和 手机 进行分词,然后找到 大米 和 手机 这两个词条的文档列表,取交集即可。这里,交集是文档 1 和 4。
最后,我们可以根据文档 ID 找到对应的文档。
索引库
Elastic 管理数据的顶层单位就是索引(Index),其类似于 MySQL 中的表;索引是文档的集合,每个文档都是一个 JSON 对象。
索引库(Index Library)是一个包含多个索引的集合,其类似于 MySQL 中的数据库。
Mapping
Mapping 是索引的配置,类似于 MySQL 中的表结构。Mapping 包含了字段的类型、是否创建索引(默认为 true)、使用的分词器、子字段等。
例如,我们有如下文档:
{
  "name": {
    "firstName": "John",
    "lastName": "Doe"
  },
  "age": 25,
  "email": "[email protected]",
  "isMarried": false,
  "bio": "John is a software engineer.",
  "examScore": [98, 97, 99]
}
我们据此创建一个 Mapping:
| 字段名 | 数据类型 | 是否需要分词 | 字段类型 | 是否创建索引 | 分词器 |
|---|---|---|---|---|---|
| name.firstName | 字符串 | 否 | keyword | true | 无 |
| name.lastName | 字符串 | 否 | keyword | true | 无 |
| age | 整数 | 否 | integer | true | 无 |
| 字符串 | 是 | text | false | 无 | |
| isMarried | 布尔值 | 否 | boolean | true | 无 |
| bio | 字符串 | 是 | text | true | ik_smart |
| examScore | 整数数组 | 否 | integer | true | 无 |
索引操作
Elasticsearch 提供了 RESTful API,可以通过 HTTP 请求对数据进行增删改查。这包括了以下几个操作:
-
PUT:创建索引例如,上文中的 Mapping 可以通过以下请求创建:
PUT /my_index
{
  "mappings": {
    "properties": {
      "name": {
        "properties": {
          "firstName": {
            "type": "keyword"
          },
          "lastName": {
            "type": "keyword"
          }
        }
      },
      "age": {
        "type": "integer"
      },
      "email": {
        "type": "text",
        "index": false
      },
      "isMarried": {
        "type": "boolean"
      },
      "bio": {
        "type": "text",
        "analyzer": "ik_smart"
      },
      "examScore": {
        "type": "integer"
      }
    }
  }
}
一旦创建了索引,就无法再修改 Mapping,只能删除索引重新创建。不过,还是可以使用
PUT请求添加字段。PUT /my_index/_mapping { "properties": { "newField": { "type": "keyword" } } } -
DELETE:删除索引DELETE /my_index -
GET:查询索引GET /my_index
文档操作
文档操作同样是通过 RESTful API 进行的。
-
POST:创建文档POST /my_index/_doc/1 { "name": { "firstName": "John", "lastName": "Doe" }, "age": 25, "email": "[email protected]", "isMarried": false, "bio": "John is a software engineer.", "examScore": [98, 97, 99] }这里,
_doc表示文档类型,1表示文档 ID。如果不指定 ID,Elasticsearch 会自动生成一个 UUID。 -
GET:查询文档GET /my_index/_doc/1如果要查询所有文档,可以使用
_search:GET /my_index/_search -
PUT:更新文档这包括了两种更新方式:覆盖更新和部分更新。
覆盖更新:
PUT /my_index/_doc/1
{
  "name": {
    "firstName": "Chris",
    "lastName": "Doe"
  },
  "age": 26,
  "email": "[email protected]",
  "isMarried": true,
  "bio": "Chris is a software engineer.",
  "examScore": [99, 98, 97]
}
部分更新:
POST /my_index/_update/1 { "doc": { "age": 27 } } -
DELETE:删除文档DELETE /my_index/_doc/1
搜索
Query DSL
Elasticsearch 使用 Query DSL(Domain Specific Language)进行搜索。Query DSL 是 JSON 格式的查询语言,可以通过 HTTP 请求发送给 Elasticsearch。
DSL 的查询条件有以下几种:
-
查询所有:
查询所有常用于测试,但在生产环境中不建议使用。
GET /my_index/_search { "query": { "match_all": {} } } -
全文搜索:
全文搜索是最常用的搜索方式,它必须搜索可以分词的字段。它常常用于搜索引擎搜索、电商商品搜索等。
如果只要匹配一个字段,可以使用
match:GET /my_index/_search { "query": { "match": { "bio": "software engineer" } } }也可以指定多个字段:
GET /my_index/_search { "query": { "multi_match": { "query": "software engineer", "fields": ["bio", "job"] } } } -
精确匹配:
精确匹配用于匹配一个字段的值,它不会对字段进行分词。它常常用于 数值、日期等字段。
一种方式是使用
term来精准匹配:GET /my_index/_search { "query": { "term": { "age": 25 } } }还可以使用
range来匹配范围:GET /my_index/_search { "query": { "range": { "age": { "gte": 20, "lte": 30 } } } } -
地理坐标查询:
地理坐标查询用于查询地理位置信息,它常用于打车、附近的人等。
首先,我们需要在 Mapping 中指定字段类型为
geo_point:PUT /my_index { "mappings": { "properties": { "location": { "type": "geo_point" } } } }然后,我们可以使用
geo_distance查询:GET /my_index/_search { "query": { "geo_distance": { "distance": "10km", "location": { "lat": 40, "lon": -70 } } } }还可以使用
geo_bounding_box查询:GET /my_index/_search { "query": { "geo_bounding_box": { "location": { "top_left": { "lat": 40, "lon": -70 }, "bottom_right": { "lat": 30, "lon": -80 } } } } } -
复合查询:
复合查询是将多个查询条件组合在一起,它包括了
bool、must、should、must_not等。bool是最常用的复合查询,它包含了must、should、must_not:GET /my_index/_search { "query": { "bool": { "must": [ { "match": { "bio": "software engineer" } }, { "range": { "age": { "gte": 20, "lte": 30 } } } ], "should": [ { "term": { "isMarried": true } } ], "must_not": [ { "term": { "email": "[email protected]" } } ], "filter": [ { "range": { "examScore": { "gte": 90 } } } ] } } }
相关性算分
Elasticsearch 使用 BM25 算法进行相关性评分。BM25 算法是一种基于概率的算法,它考虑了查询词的频率、文档长度等因素。
BM25 算法的公式如下:
\[\text{score}(D, Q) = \sum_{i=1}^{n} \text{IDF}(q_i) \cdot \frac{f(q_i, D) \cdot (k_1 + 1)}{f(q_i, D) + k_1 \cdot (1 - b + b \cdot \frac{|D|}{\text{avgdl}})}\]其中:
- \(D\):文档
- \(Q\):查询
- \(q_i\):查询词
- \(n\):查询词数量
- \(\text{IDF}(q_i)\):逆文档频率
- \(f(q_i, D)\):查询词在文档中的频率
- \(k_1\):调节参数
- \(b\):调节参数
- \(\|D\|\):文档长度
- \(\text{avgdl}\):平均文档长度
在使用 BM25 算法之前,Elaticsearch 使用的是 TF-IDF 算法。TF-IDF 算法是一种基于词频的算法,它考虑了查询词在文档中的频率。它的缺点是词条频率过高时,会导致相关性评分过高。而 BM25 算法则解决了这个问题。
然而,有时候我们并不一定需要最相关的结果。例如,假设有一天李彦宏突发奇想,希望在搜索 原神 编程语言 时,百度第一个词条是 Rust。这时候,我们就需要调整相关性评分,手动干预搜索结果:
GET /my_index/_search
{
  "query": {
    "function_score": {
      "bool": {
        "must": [
          {
            "match": {
              "q": "原神"
            }
          },
        ],
        "should": [
          {
            "match": {
              "q": "编程语言"
            }
          }
        ]
      },
      "functions": [
        {
          "filter": {
            "match": {
              "q": "Rust"
            }
          },
          "weight": 100
        }
      ],
      "boost_mode": "sum"
    }
  }
}
这里解释一下 boost_mode。boost_mode 有以下几种模式:
-
multiply:将所有函数的评分相乘 -
sum:将所有函数的评分相加 -
avg:将所有函数的评分求平均 -
max:取所有函数的最大值 -
min:取所有函数的最小值
聚合
聚合是 Elasticsearch 的一个重要功能,它可以对搜索结果进行统计、分析等。
一个完整的搜索包含了以下几个部分:
-
query:查询条件这个我们在前面已经介绍过了。
-
from和size:从第几条开始以及返回多少条这两个参数用于分页。Elaticsearch 无法返回超过 10000 条的结果,所以如果需要返回更多结果,可以使用
scroll。 -
sort:排序可以根据多个字段进行排序,也可以指定升序或降序。
对于地理坐标,可以使用
_geo_distance进行排序。其排序的是距离目标点的距离。 -
aggs:聚合聚合用于对搜索结果进行统计、分析等。聚合可以嵌套,可以对多个字段进行聚合。
其可以:
- 对桶进行聚合:例如,按照年龄、性别等字段进行聚合
- 对度量进行聚合:例如,计算平均年龄、最大年龄等
- 对管道进行聚合:综合上面两种聚合
-
highlight:高亮高亮用于标记搜索结果中的关键词。也可以自己设置样式等。
GET /my_index/_search
{
  "query": {
    "match": {
      "bio": "software engineer"
    }
  },
  "from": 0,
  "size": 10,
  "sort": [
    { "price": "asc" },
    {
      "_geo_distance": {
        "location": {
          "lat": 40,
          "lon": -70
        },
        "order": "asc",
        "unit": "km"
      }
    }
  ],
  "aggs": {
    "avg_age": {
      "avg": {
        "field": "age"
      }
    }
  },
  "highlight": {
    "fields": {
      "bio": {
        "pre_tags": "<em>",
        "post_tags": "</em>"
      }
    }
  }
}
应用
自动补全
自动补全是一个常见的搜索功能,它可以在用户输入时实时提示搜索结果。
自定义分词器
由于希望用户输入几个字母,但能够搜出中文词,所以我们需要使用  拼音分词器。

这个拼音分词器只会将单个汉字转换为拼音,我们需要定制一个分词器,将多个汉字转换为拼音。分词器和 Mapping 定义在一起:
PUT /my_index
{
  "settings": {
    "analysis": {
      "analyzer": {
        "pinyin_analyzer": {
          "tokenizer": "ik_max_word",
          "filter": ["pinyin_filter"]
        }
      },
      "filter": {
        "pinyin_filter": {
          "type": "pinyin",
          "keep_full_pinyin": false,
          "keep_joined_full_pinyin": true,
          "keep_original": true,
          "limit_first_letter_length": 16,
          "remove_duplicated_term": true,
          "none_chinese_pinyin_tokenize": false
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "name": {
        "type": "text",
        "analyzer": "pinyin_analyzer",
        "search_analyzer": "ik_smart"
      }
    }
  }
}
自动补全查询
Elasticsearch 提供了 completion 类型,用于自动补全。completion 类型是一种特殊的字段类型,它会将字段的值进行分词,然后将所有可能的前缀存储在一个特殊的数据结构中。
PUT /my_index
{
  "mappings": {
    "properties": {
      "title": {
        "type": "completion"
      }
    }
  }
}
然后,我们可以使用 suggest 查询来进行自动补全:
GET /my_index/_search
{
  "suggest": {
    "title-suggest": {
      "text": "原神",
      "completion": {
        "field": "title",
        "skip_duplicates": true,
        "size": 10
      }
    }
  }
}
同步 MySQL 数据
Elasticsearch 提供了 jdbc 插件,可以将 MySQL 数据同步到 Elasticsearch。
同步主要包含三种:
-
同步调用
服务首先将数据写入 MySQL,然后调用 Elasticsearch API 将数据写入 Elasticsearch。
-
异步通知
服务首先将数据写入 MySQL,然后发送消息到消息队列。Elasticsearch 服务监听消息队列,将数据写入 Elasticsearch。
-
监听 MySQL binlog
MySQL 每次写入数据时,都会将数据写入 binlog。
Elasticsearch 通过 canal 监听 MySQL binlog 变化,将数据写入 Elasticsearch。
集群
配置
通常,使用 docker-compose 部署 Elasticsearch 集群比较方便。我们可以使用以下配置:
version: '3.7'
services:
  es01:
    image: docker.elastic.co/elasticsearch/elasticsearch:8.17.2
    container_name: es01
    environment:
      - node.name=es01
      - cluster.name=es-docker-cluster
      - discovery.seed_hosts=es02,es03
      - cluster.initial_master_nodes=es01,es02,es03
      - bootstrap.memory_lock=true
      - "ES_JAVA_OPTS=-Xms512m -Xmx512m"
    ulimits:
      memlock:
        soft: -1
        hard: -1
    volumes:
      - data01:/usr/share/elasticsearch/data
    ports:
      - 9200:9200
    networks:
      - elastic
  es02:
    image: docker.elastic.co/elasticsearch/elasticsearch:8.17.2
    container_name: es02
    environment:
      - node.name=es02
      - cluster.name=es-docker-cluster
      - discovery.seed_hosts=es01,es03
      - cluster.initial_master_nodes=es01,es02,es03
      - bootstrap.memory_lock=true
      - "ES_JAVA_OPTS=-Xms512m -Xmx512m"
    ulimits:
      memlock:
        soft: -1
        hard: -1
    volumes:
      - data02:/usr/share/elasticsearch/data
    networks:
      - elastic
  es03:
    image: docker.elastic.co/elasticsearch/elasticsearch:8.17.2
    container_name: es03
    environment:
      - node.name=es03
      - cluster.name=es-docker-cluster
      - discovery.seed_hosts=es01,es02
      - cluster.initial_master_nodes=es01,es02,es03
      - bootstrap.memory_lock=true
      - "ES_JAVA_OPTS=-Xms512m -Xmx512m"
    ulimits:
      memlock:
        soft: -1
        hard: -1
    volumes:
      - data03:/usr/share/elasticsearch/data
    networks:
      - elastic

volumes:
  data01:
    driver: local
  data02:
    driver: local
  data03:
    driver: local

networks:
  elastic:
    driver: bridge
然后运行:
docker-compose up -d
脑裂
脑裂是 Elasticsearch 集群中的一个常见问题。脑裂是指集群中的节点之间出现了分裂,导自了数据不一致。
Elasicsearch 集群中的节点有以下几种角色:
-
Master 节点
Master 节点负责集群的管理,例如管理和记录集群状态、决定分片所在的节点、处理创建和删除索引库的请求等。它要求 CPU 强。
设置为 Master 节点的节点只是备选主节点,而真正的主节点是通过选举产生的。
配置时,可以通过
node.master来指定是否为 Master 节点。 -
Data 节点
Data 节点负责数据的存储、搜索、聚合、添加、修改等。他要求内存大、CPU 强。
配置时,可以通过
node.data来指定是否为 Data 节点。 -
Ingest 节点
Ingest 节点负责数据的预处理。
配置时,可以通过
node.ingest来指定是否为 Ingest 节点。 -
Coordinating 节点
Coordinating 节点负责请求的转发及结果的合并。它要求网络带宽大、CPU 强。
配置时,以上三个参数都为
false。
如果某一时刻,当前主节点宕机了,那么剩下的节点会重新选举主节点。这个过程称为主节点选举。
而过了一会儿,这个宕机的主节点又恢复了,这时候集群就出现了两个主节点。这个时候,就会出现脑裂。
解决脑裂的方式是:一共设置奇数个 Master 节点,然后进行主节点选举,选票超过半数的节点成为主节点。
分布式存储
Elasticsearch 是一个分布式存储系统,它将数据分片存储在不同的节点上。分片的计算公式如下:
\[\text{shard} = \text{hash}(\text{routing}) \mod \text{num\_primary\_shards}\]其中:
-
routing:路由字段,用于计算分片。如果没有指定路由字段,那么会使用文档 ID。 -
num_primary_shards:主分片数量。默认为 5。
分片分为主分片和副本分片。主分片用于存储数据,副本分片用于备份数据。副本分片数量可以通过 number_of_replicas 参数指定。
分布式查询
查询会打在 Coordinating 节点上,然后由 Coordinating 节点将查询请求转发给所有 Data 节点。Data 节点会将查询结果返回给 Coordinating 节点,然后由 Coordinating 节点将结果合并后返回给客户端。
故障转移
Elasticsearch 提供了故障转移机制,可以在节点宕机后自动将数据迁移到其他节点。
当主节点宕机后,备选主节点会重新选举主节点。新的主节点监测集群状态,如果发现有分片没有副本节点,就会将分片迁移到其他节点。
采用 CC BY-NC-SA 4.0 许可,转载时请注明作者与来源。
评论